10/25 成功
GPT-6 Astra+固定技能。平均分 47.5 / 100,全程不调用 VLA。
 ZIWU AIEmbodied Intelligence Measurement
无论动作来自 VLA 策略(Simate-beta、π0 系列、Xiaomi-Robotics),来自大模型规划器(目前为 GPT-6 Astra,可替换),还是由 GPT-6 Astra 调度 Simate,ZIWU 都把运行整理成任务图:任务目标、运行状态、失败位置与视频和原生结果对齐,用来比较控制方式,并筛出“出现故障、修正、重新取得进展”的恢复轨迹。
GPT-6 Astra+固定技能。平均分 47.5 / 100,全程不调用 VLA。
GPT-6 Astra+可选 Simate。平均分 56.1 / 100;10 次成功中 5 次没有实际调用 Simate。
Simate(VLA):Simate-beta 单独控制。平均分 21.6 / 100,不调用 GPT-6 Astra。
任务图自动筛出「故障 → 修正 → 重新取得进展」的回合 24 条,正在用人工盲标核对准确率与召回率。
同一任务、同一布局下,把 VLA、大模型规划器和大模型调度 VLA 的运行放进同一张图,比较成败、过程和失败位置,而不只看一个成功率。
新版本仍然成功,却变慢、绕路、抖动或依赖更多修正;成功率无法单独反映这些过程变化。
在任务图上找出“掉了、倒了、抓空、对不准”之后又修正并重新取得进展的片段,附故障、修正、恢复的步号,回到录像即可核对。
恢复片段和失败位置交给复盘模型,修改执行代码与配置(模型权重不变);改动是否保留,由同布局、同预算的配对实验决定。
汇总所有电脑上的 Claude Code、Codex 会话;整理成工作流、规则和踩坑,生成关系图、流程图和技能,与团队共享。
npm install -g @ziwu-ai/ziwu-agent上传任意控制方式的运行数据(VLA、大模型规划、两者结合)生成任务图,对照视频与原生结果回放,标出故障与恢复,并用人工标注检验筛选结果。
Connector 接入运行,Graph 记录任务与运行关系,Visualization 展示差异;结果可用于选型、门禁、数据采集和复测。

图中将 Agent、机器人和世界模型运行统一为事件,并映射到语义任务图、任务地形和度量坐标;结果保留版本、视频、action 和原生输出来源。
Task / Robot / Policy / Episode
Metric / Failure / Evidence
Workflow / Landscape / Replay
Match / Gate / Route / Retest
Test Cell → Robot Town
评测结果用于后续部署、训练和复测。
将同任务的 101 条轨迹按可追溯行为分组,并区分 demo 与 policy truth。
Goal、当前状态、目标距离和中文说明沿时间轴同步显示。
三路相机、逐步 action、原生 score 与运行 manifest 对齐到同一个 step。
规划将成功率、执行成本和经验证的过程指标用于发布门禁;当前尚未形成完整闭环。
对终点相似的运行,比较耗时、路径、方向反转和低活动步。
基础设施 pass 仅表示环境可运行,与 policy success 分开记录。
本节列出各类证据可以支持和不能支持的结论。
GPT-6 Astra+固定技能、GPT-6 Astra+可选 Simate、Simate(VLA)在同一布局上同步回放,看谁插进去、在哪里出错、出错后有没有恢复。
任务要求把四个蛋放入蛋盒、关盖并让机器人回到原位。两个官方示教以真实速度同步起播:Episode 2 在 10.80 秒结束,Episode 54 还要继续 18.64 秒。
两次运行耗时分别为 10.80 秒和 29.44 秒。同步多视角回放用于核对额外动作发生在哪个阶段,并将耗时、动作路径、方向反转和低活动步记录为可复测指标。
绿色代表 Episode 2,橙色代表 Episode 54。全部数字来自官方示教视频与 14 维 action;没有 ground truth 的成功分不会填成 0 或 100。
每根柱子聚合一段 14 维 action 的相邻变化量。点击柱子可以跳回相应视频时间;Episode 54 的时间轴横跨 29.44 秒,因此相似终点背后的额外等待与反复修正仍可检查。
Fold Clothes 官方示教用来展示肉眼难以稳定识别的 4%–10% 级质量差异。
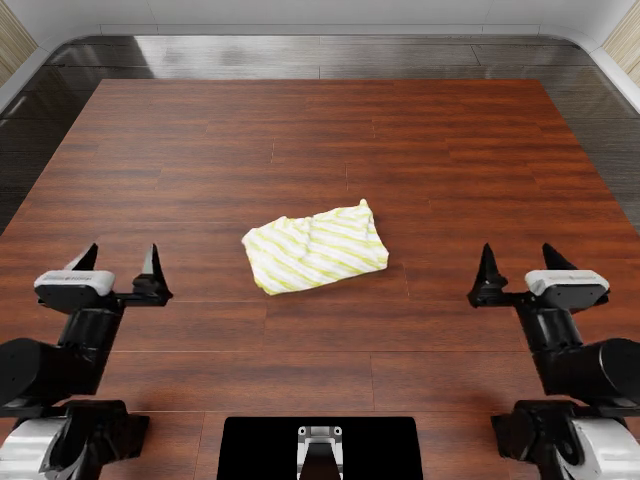

Episode 36 的动作空间路径更短;同时快 4.2%,最终轮廓矩形度代理高 5.9%。这组差异幅度较小,可用于说明持续评测与回归检测的作用。
下载 Fold Clothes 报告